 零一时代新媒体实训中心
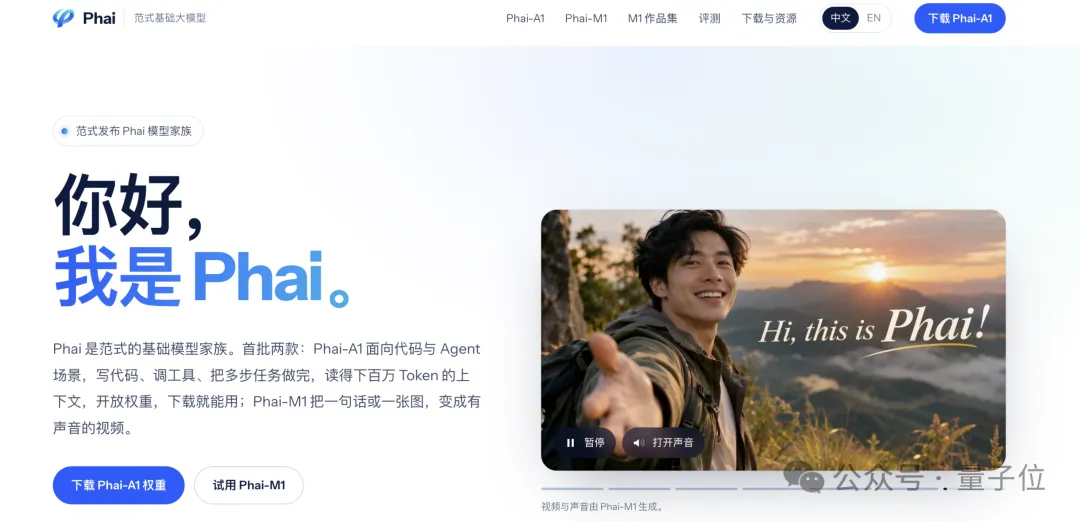
范式智能发布Phai-A1语言模型和Phai-M1视频模型,单张3090显卡即可运行,3分钟生成15秒720P视频,近期开源。
做短视频、做直播、自己写文案的人,这条值得看一眼:范式智能(原第四范式)把两个自研模型摆到了台前,Phai-A1 是通用语言模型,Phai-M1 是面向真人影视场景的视频生成模型。
Phai-A1 的官方口径:同样质量下,响应速度比同参数级别模型快 8-10 倍,原生百万级上下文,单张消费级 RTX 3090 就能跑。
官方说它在 SWE-Bench-Verified、SWE-Bench-Pro、SWE-Bench-Multilingual 上跑赢同级别选手,不弱于一些千亿参数级模型;在自家 AI 办公产品 PhanthyCode 的匿名期里,模型能力、稳定性与速度、体验满意度三项评分最高。
Phai-M1 主打音画同步——声音和画面在同一条生成流水线里出来,不用后期对口型。约 3 分钟生成一条 15 秒 720P 视频。
两个模型全流程在华为昇腾平台上做专项后训练优化,不是训完再适配,是从优化阶段就按国产算力环境设计。两个月前有消息称范式超 10 亿元采购华为昇腾 950。
官方说近期在 Hugging Face、ModelScope 开放权重,目前已接入 PhanRouter、ModelSphere、Phanthy(万神殿)、PhanthyMovie、PhanthyCode/Work 等产品。
最扎心的一条:要排队、要按次付费的活儿,门槛正在往下掉。一张 3090 是消费级显卡,不是机房里的卡。写文案、改脚本、批量回客户消息这类天天干的杂活,从打开网页看它转圈,变成本机随叫随到。
对做短视频和直播的,M1 那个 3 分钟 15 秒更值得盯。一条 60 秒的成片,素材要分几轮跑、再拼起来,时间是能坐下来算清楚的。原文那句话点得准:生成时长和速度直接决定产线的节奏和成本,这是能重新算一遍账的事。
也要看清它的定位:面向真人影视场景做专项训练,官方说的是人物表现、画面细节、整体质感做到影视级水准。能不能进你的日常出片流程,得拿你自己的素材去试,别只看演示片。
这件事我们课上刚聊过。零一时代新媒体实训中心在天津,来的多是实体店老板和做号的人,卡住的地方从来不是模型强弱。
我见过不少天津的店主就卡在这一步:工具收藏了一堆,一个都没真用起来。
上个月还有学员拿着 AI 生成的视频来问能不能直接发。零一时代新媒体实训中心就四门课,问得最多的是短视频获客和 AI 应用。
问:一张 3090 就能跑,我在家也能部署吗?
答:官方说法是单张 RTX 3090 就能跑,一台普通笔记本双击就能跑,不用云端排队、不用 API 计费。真上手还要看显存、模型文件和工具链,别把能跑理解成不用折腾。
问:3 分钟生成 15 秒,做短剧够用吗?
答:真正省下来的是试错成本——一条不满意重跑,等 3 分钟,而不是等一晚。够不够用,看你能接受多少条里出一条。
问:全流程国产算力训练,跟我有什么关系?
答:短期你感受不到。它的意义是降低对单一硬件平台的依赖,也让国产芯片在真实训练和应用里攒经验。这类事攒够了,才会体现在你用得起的工具上。
想动手又不知道从哪下手,天津和京津冀的可以来零一时代新媒体实训中心坐坐,电话 18622876609。