通研院团队盯上自我进化 AI:你的经验能不能存成模型资产
做内容、开店的人注意:AI 正从通用工具转向专属模型,长期积累的经验可以沉淀,换模型底座也不必从零开始。
到底发生了什么
北京通用人工智能研究院(BIGAI)体系孵化的团队「通衍灵智」,把方向押在 Personal AI 上——给个人和企业做能持续进化的专属模型。
它的技术路线是:共享基础模型加轻量化的 Personal LoRA 个性化参数。通用能力由底座提供,你的偏好和行为特征由这些小参数承载。
训练方法叫 RSI,递归自我改进。流程是:业务里产生的任务轨迹、人工修正、实际结果变成候选数据,Evaluator 按你定的评价标准筛一遍,有效的才拿去增量更新 Personal LoRA;更新完要和旧版本在同一批任务上重跑对比,确认提升才上线,退化就回滚。
同一条路上,OpenAI 用 Dreaming 改进 ChatGPT 的长期记忆,Meta 的 Muse 把个性化理解和自主执行放在一起,让 Personal Agent 从回答问题走向完成任务。
进度得说清楚:通衍灵智表示,RSI 的技术路线与产品架构已经明确,相关模块在推进工程化,完整的自动化流程还在研发阶段。
成本侧它做了两件事。TIP 训推并行,让训练和在线推理抢同一批算力;Paged LoRA 用分页管理,让大量个性化参数共享显存。已完成的测试里,用 Qwen2.5-72B-Instruct 加 8 张 NVIDIA H800,Paged 和传统 Flat 模式的 LoRA 显存预算都控制在 5.79GB;LoRA 请求占比 1% 到 30% 时,Paged 在响应延迟和长尾表现上有优势;占比提到 50%,频繁换入换出还是会出现性能退化。
这对你意味着什么
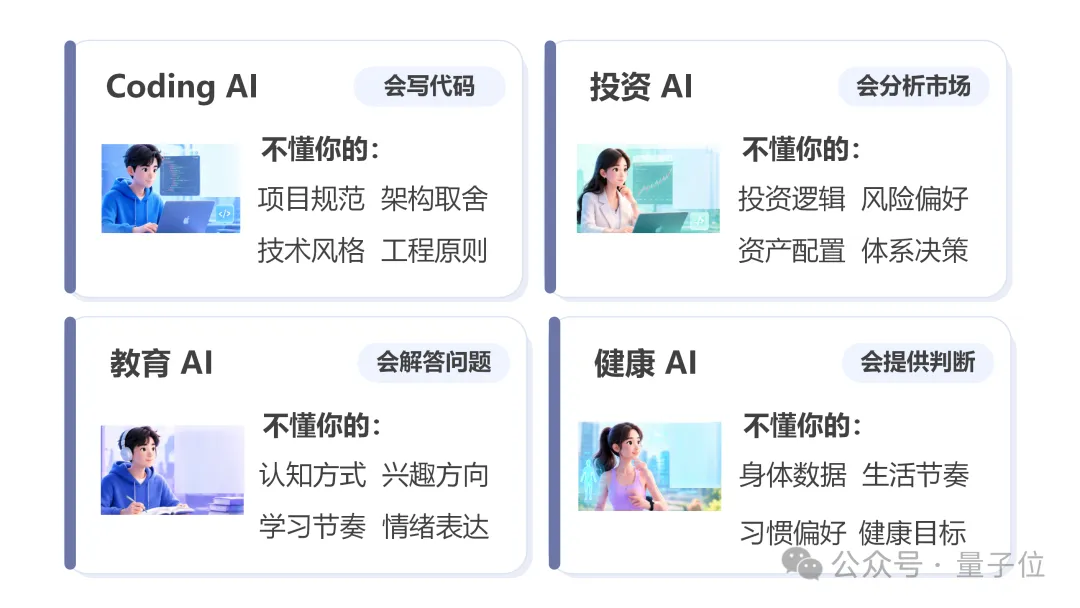
你现在用 AI,基本都是问一句答一句。Prompt、RAG、Memory、Skill 这些机制都在模型外部组织信息,模型本身的参数不会因为你聊了一百次就变。
这条路想改的正是这一点:把你反复验证过的判断,从「每次重新说一遍」变成「存在模型里」。
- 开店的:你挑货的眼光、老客砍价怎么接、售后怎么收场,现在多半在你脑子里和嘴巴上,人一走就断。
- 做号的:爆款脚本的结构、评论区怎么回、哪种开头留人,每次起新号是不是又从零开始想。
- 带团队的:资深员工才知道哪些客户不能碰、哪些单不能接,这些没写下来的东西,就是原文说的「分散在长期实践里」。
但别把它当成明天就能买的东西。官方自己说完整自动化还在研发;测试里请求占比到 50% 就出现性能退化;Personal LoRA 通常还不能跨模型直接复用,换底座要靠你积累的业务数据、任务轨迹、人工反馈和评测体系重新适配。
还有一条容易忽略:原文明确说,数据权利、知识产权和模型成果归属,要靠合同、授权和数据治理机制约定,技术分层本身不产生法律上的所有权。
这事我们课上刚聊过:不少天津实体店老板,连自己那套老客话术都还在脑子里,没整理成文字,更谈不上喂给模型。
接下来可以怎么做
- 先别问「哪家能给我训个专属模型」,先把你店里、号里那套做法写成文档,哪怕就是二十条话术、十条选品标准。
- 用现有的提示词、知识库、Agent 把流程跑起来。原文说得明白:动态知识仍然要检索,任务状态仍然要记录,这些机制不会因为参数化学习就作废。
- 给自己建一套评价标准。同一件事让 AI 做三遍,你按自己的尺子打分。原文提到,有了这套评测体系,换模型时你能自己比,而不是只看厂商给的通用指标。
- 把每次人工修改存下来。你改过的那一版,比 AI 出的第一版值钱。
零一时代新媒体实训中心开的四门课——短视频获客、直播带货、AI 应用、TikTok 跨境电商,教的都是把做法变成流程。
新手最常问的 3 个问题
问:这跟我现在用的 AI 助手有啥区别?
答:区别在参数层。现在的助手靠提示词、知识库、记忆在模型外部兜信息;这条路想让模型本身的参数带上你的习惯。前者换个对话框就没了,后者理论上能跟着你走。
问:以后换模型,我攒的东西是不是清零?
答:通衍灵智 CEO 谢枭楠的说法是不会。Personal LoRA 通常不能直接跨模型复用,但业务数据、任务轨迹、人工反馈和评测体系可以在新模型上重新适配,不用从零开始。
问:现在做号、开店的人需要动手吗?
答:需要动手的是整理,不是采购。技术还在工程化阶段,但「把你的经验变成结构化数据」这件事,今天做和明年做,成本差很多。
一句话收口
AI 变聪明不稀奇,稀奇的是它变聪明的同时,你手里也攒下了东西。零一时代新媒体实训中心在天津有 9 大直营校区,天天打交道的就京津冀这批店主和中小企业主,这波变化我们盯着。
本文由零一时代新媒体实训中心编辑整理,基于原文改写,仅供学习参考,观点不构成投资与经营建议。